How We Taught Gemini to Hear Russian Inside Serbian
No public ASR handles word-level Russian–Serbian code-switching. We benchmarked 15 models and built our own solution on Gemini.
...and why closely related languages are the worst case for AI
TL;DR: A Serbian teacher switches to Russian mid-sentence, and it breaks almost every commercial transcription service on the market. We tested fifteen models, built our own solution on Gemini (running in Jazion for half a year), and packed it all into a PDF of hard-won prompting lessons.
This is a story I've been meaning to tell for a while. It's code-switching, switching between languages right in the middle of a phrase, that sets transcription for a language lesson fundamentally apart from ordinary monolingual transcription, and raises the bar so high that few can clear it today. For half a year I kept coming back to this problem, and the other day, re-checking model quality on one of the most fascinating and difficult pairs, Russian–Serbian, I realized it was time to tell how we cleared it, and how Gemini helped us do it.
Every transcriber's nightmare: aggressive code-switching
Here is a fragment of an ordinary online Serbian lesson. The teacher is a native speaker; the students are native speakers of Russian. The lesson runs in Serbian, but look closely:
[12:04] Mila: Pogledaj, ovo je akuzativ. Смотри, здесь окончание меняется. Jasno?
[12:09] Luka: Da, понятно. Akuzativ — je kao винительный?
(The dialogue is synthetic but faithfully reproduces the structure of real lessons: we don't publish students' actual lines.)
Let's fix the words first; they'll come up more than once. A language lesson usually has two languages: the target language being learned (we'll call it Target; here, Serbian) and the student's native language (Native; here, Russian). There are exceptions: a full-immersion lesson can run entirely in the Target, and sometimes a third language is woven in as an example. But for learning it's the Target that matters most, and most often it's the Target–Native pair that collides inside a single sentence.
In the lesson recording we use to measure quality, roughly every fourteenth word comes from the native language, Russian. This is neither an accident nor "contaminated" speech: the teacher deliberately doubles a difficult point in Russian, and the student answers in a mix because that's how thinking goes faster. Linguists call it code-switching: switching languages within a conversation, sometimes within a single sentence. When it happens word by word, jumping mid-phrase, it's called aggressive, exactly the case in our title. For bilinguals it's a way of life; for a language teacher, a working tool.
For speech recognition systems it's a nightmare.
We fed a recording like this to fifteen models: specialized transcription services and general-purpose multimodal AI. Most of them failed. Below: what exactly broke, for whom, and why we ended up building our own solution.
What services promise vs what a lesson needs
Almost every service claims "70+ languages supported". The mechanic behind it is simple: it listens to the first few seconds, decides the language of the whole file, and from then on expects nothing else. At best it survives a couple of international words like "ok" or "marketing".
A lesson needs more. A lesson needs the system to switch on every single word: "Pogledaj" is Serbian, "смотри" is Russian, and they stand side by side. Without that, nothing the school records the lesson for actually works: you can't count how much the student spoke in the target language, you can't build a vocabulary of new words, you can't see the progress from "answers in Russian" to "answers in Serbian". The share of the native language in a student's speech is, in essence, an inverted progress bar, and to draw it, every word must be attributed correctly.
Funny thing: the Russian–Serbian pair is harder for machines than, say, Russian–English, precisely because the languages are similar. Shared roots, related vocabulary and, the dirtiest trick of all, Cyrillic: Serbian is officially written in two alphabets, and Cyrillic Serbian looks almost indistinguishable from Russian. The model "hears" familiar Russian words in Serbian speech, and vice versa. In bilinguals something similar is called cross-language activation (both languages stay active at once, and similar words compete); in models we've nicknamed it linguistic colour-blindness: the system sees that the words differ but cannot tell their colours apart.
One note before we go on: none of this is limited to Russian–Serbian. Our pipeline handles any Target–Native pair: Russian–English, Russian–Spanish, English–German. We picked Russian–Serbian as the hardest exam: close languages, a shared alphabet, and almost no ready-made solutions.
Serbian, the orphan of the ASR world
Serbian has a separate problem, and it's not about code-switching. Almost nobody supports it.
In winter we combed the market of speech recognition systems (ASR, automatic speech recognition) and found a pattern that at first looked like a joke: Croatian appears in supported-language lists roughly twice as often as Serbian. NVIDIA's fresh open models Parakeet and Canary cover 25 European languages: Croatian is in, Serbian is not. Speechmatics: Croatian yes, Serbian no. Voxtral by Mistral, Qwen3-ASR by Alibaba, Yandex SpeechKit: no Serbian at all. AssemblyAI released its new model generation in early 2026 and cut the language list down to six; Serbian didn't make it. Low-resource languages don't gain support over time, as one might hope. They lose it.
[!spotlight] On the difference between Serbian and Croatian (ChatGPT, December 2025, translated): When transcribing audio, the difference between Serbian and Croatian stops being academic and becomes very practical. Here are cases where one wrong decision instantly "gives away" the language.
1) Ekavian vs Ijekavian reflex. The most frequent audible marker. Serbian: mleko, vreme, dete. Croatian: mlijeko, vrijeme, dijete. If a transcript says mleko instead of mlijeko, a Croatian text instantly turns into a Serbian one.
2) Same meaning, different words. Serbian: voz, hiljada. Croatian: vlak, tisuća. A speaker will say exactly one of them; there is no "universal" option.
3) The letter H that Serbs love to "lose". In Serbian speech h often reduces or disappears: you hear леб, ладно where Croatian writes hljeb, hladno. A transcript must record what was actually said, not "restore" the letter automatically.
4) Future tense, joined or separate. Sounds nearly identical, differs fundamentally in writing. Serbian: uradiću. Croatian: uradit ću.
5) Đ vs DŽ. Croatian distinguishes them strictly; Serbian is more permissive. Đevojka sounds soft, almost like a single consonant, and in a Croatian transcript it must be đ, not dž.
Bottom line: when transcribing audio, what matters is not only what was said but within which language norm it was said. Serbian and Croatian sound like twins, but on paper they immediately start arguing over their passports.
The temptation is real: if the languages are that close, why not transcribe Serbian with a Croatian model? We tried. It works, right until the first glass of milk and any other word where Ijekavian gives Croatian away. Serbian teachers spot it instantly: our AI assistant once generated an exercise with Ijekavian forms, and we heard about it within a day. Since then the language norm is nailed down in every single prompt. The native speakers, by the way, joke about it better than we ever could: forty years ago "Top Lista Nadrealista" pushed "four languages in one" to absurdity in a legendary sketch.
How do you even measure a "good transcript"
Before showing the table, a word about what the numbers mean. We promise: one formula for the whole article, and a school-grade one.
Imagine the reference phrase is "mama je kupila mleko". The model heard "mama kupila mlijeko sutra". It lost one word (je), distorted one (mleko → mlijeko) and added an extra one (sutra). Three errors against four reference words: an error share of three quarters, or 75%. That is WER (word error rate): substitutions, deletions and insertions, divided by the reference length. Lower is better; zero is perfect.
WER has one amusing property: it can exceed 100%. If a model generates more garbage than there were words in the reference, the counter goes past a hundred. Remember this; such a character appears in our tests.
The second metric is DER (diarization error rate): how often a line is attributed to the wrong person. Diarization answers the question "who was speaking", and in a group lesson with six participants it matters no less than word accuracy: a student's statistics assembled from someone else's lines are worse than no statistics at all.
Under the hood these metrics have their own subtleties: we compare Serbian across its two alphabets through transliteration and filter out "uh-huh" and "hmm" as noise. But the real pain is the reference, a manually verified transcript without which there is nothing to compare against. Ours took four hours of painstaking annotation for twenty-five minutes of audio. If anyone ever tells you data annotation is easy, show them a Serbian lesson with six speakers.
Six months from pain to breakthrough
We have been wrestling with this problem since November 2025. First we learned to measure it: built the manual reference and ran everything the market had to offer through it. The specialized services failed one after another, some not knowing Serbian, some knowing it but losing the Russian insertions. Then came two days of near-nonstop prompting, and on December 23rd the breakthrough: Gemini learned to hold both languages at once, under 17% word errors and around 10% speaker errors. It was the best result for word-level switching on a low-resource language we had seen anywhere. That solution has been quietly running in Jazion for half a year now: teachers get lesson summaries, vocabularies and that very "share of Russian" that shows progress better than any test. The main takeaway of these six months is simple: word-level code-switching is a solvable problem, but we had to build the solution ourselves. We never told the story of how. Fixing that now, and re-checking the market along the way: maybe it has caught up with us?
June 2026: re-checking the market
We ran the same audio fragment through the current versions of all the major services, including the new Gemini generations. Here is the digest:
| Service | Word errors (WER) | Who spoke (DER) | What happens to Russian insertions |
|---|---|---|---|
| Gemini (our configuration) | 24% | 18% | catches them and writes them in Russian |
| ElevenLabs Scribe v2 | 29% | 20% | transliterates into Latin |
| OpenAI gpt-4o-transcribe | 36% | no diarization | doesn't hear them at all |
| AssemblyAI Universal-2 | 42% | 42% | loses half |
| Deepgram Nova-3 | 51% | 29% | drowns Serbian in Russian |
| Gladia | 75% | 49% | writes everything in Russian |
| Whisper large-v3 | 77% | 63% | flip-flops between alphabets |
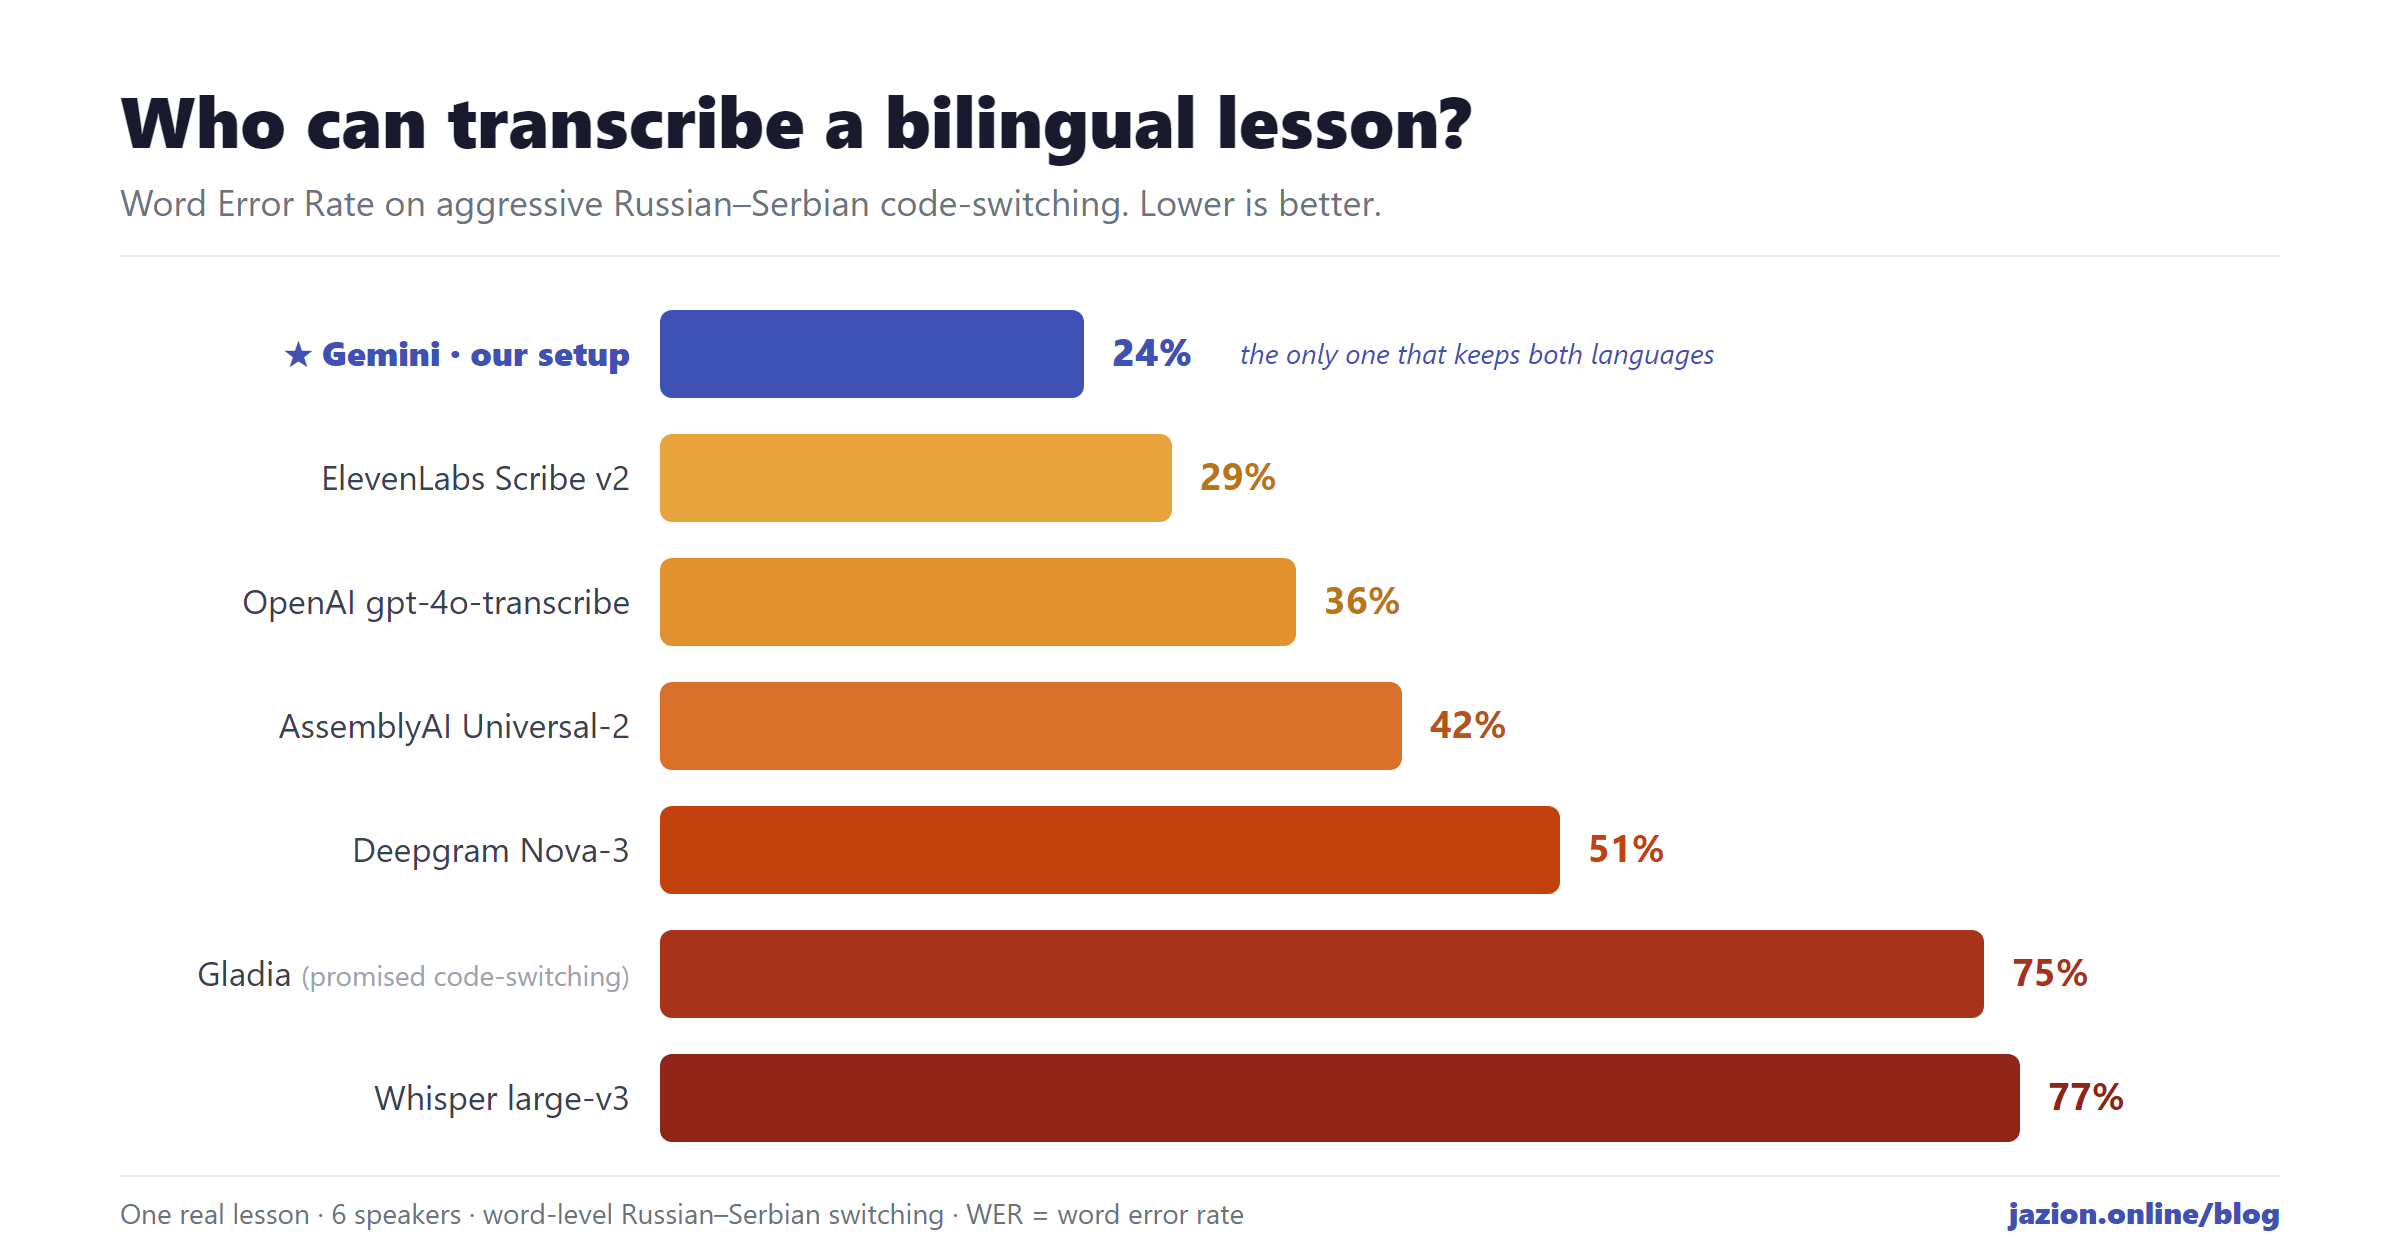 Word Error Rate by service: Gemini in our setup keeps both languages, the rest climb into a wall of errors
The most important thing in the table is not the numbers, it's the last column. Every service fails in one of two ways, and both make the lesson data useless. Some are deaf to Russian: gpt-4o-transcribe didn't write a single Russian word, Scribe neatly re-spells Russian in Latin. For a student's statistics those are simply lost lines. Others drown in Russian: Gladia, the only service that officially promises word-level switching, heard the Russian insertions and wrote almost the entire Serbian lesson in Russian: against 67 Russian reference words it produced 440. Not one specialized service kept both languages in balance. Which means that from transcripts like these a school cannot tell how much the student actually spoke Serbian. That is the wall we built our own solution to clear.
In fairness: Scribe turned out to have excellent diarization, the best among the "pure" ASR systems we tested. If our lesson were monolingual, it would be a strong choice. It was the language that killed it.
To the best of our knowledge (and the June benchmark confirms it), no public speech recognition service today handles word-level Russian–Serbian switching at a usable level. We couldn't find a solution. So we built one.
[!mascot] purrs in two languages «Mačke razumeju sve jezike. Мы просто отвечаем на своём.» ("Cats understand all languages. We just answer in our own.") 🐾
Why a generalist model beat the specialists
Our solution is built not on an ASR service but on a multimodal model, Google Gemini. The difference is fundamental. A specialized recognition model learns to map sound to letters; its language list is literally a list, and Serbian rarely makes it in. A large multimodal model has been trained on vast amounts of text and speech, Serbian forums, textbooks, subtitles and audio among them. It knows not only how Serbian sounds but also how mixed speech behaves, and it understands the instruction "write Russian words in Cyrillic, Serbian words in Latin" as a meaningful rule rather than a config flag.
In practice it looks like this: Gemini transcribes thirteen minutes of a six-voice lesson in half a minute, with diarization, both languages and the correct Ekavian forms. The cost is a pleasant footnote: transcribing a full hour of a lesson comes out cheaper than a cup of coffee, and the market keeps getting cheaper overall (a rare exception is AssemblyAI, raising its regional processing price by 10% from July). We also tried the specialized Google Speech v3: on our data it loses even to the junior Gemini models, which is a sign of the times in itself. Generalist models have started beating narrow specialists on their home turf.
We go back a long way with Gemini: in our previous project, Emotions Shazam, it did a great job analyzing prosody, the intonation and emotion in speech. But honest praise means naming the limits too: word-level timestamps on long recordings (an hour and more) are still unstable, and getting it to reliably tell Serbian from Russian in word-level switching took many iterations before and after; the decisive breakthrough came together over a couple of intense days of nonstop prompting. We packed the details into a separate cheatsheet at the end of the article.
💡 How this works in Jazion: language-separated transcription is not a feature, it's the foundation. On top of it the platform automatically builds the lesson summary, each student's personal vocabulary (how that works, we tell in our DDL post), speech statistics and the lesson-by-lesson dynamics of the "native language share". For the teacher, all of it is one button after the lesson.
Quality, kept in check
Models don't stand still: they get updated, and over time their behavior shifts. This is a well-known phenomenon, model drift, and we have already run into it on our own data. That is why we keep a reproducible benchmark and use it to regularly re-check both the market and our own quality. If something slips somewhere, we are the first to notice and we re-tune the configuration. For a school this means something simple: your transcription quality is being watched, not left to chance.
🔧 Take it with you: prompting lessons we paid for in hours
We don't publish our production prompt: it's our know-how. But the lessons learned in a days-long fight with code-switching transfer to any task, from transcription to exercise generation. We packed them into a two-page PDF: ten rules, the CRITICAL/MUST/NEVER hierarchy of mandate words, and a tested demo prompt you can try on your own recording in Google AI Studio right now.
Download PDF EN (Registered only)
The bottom line
Serbian is the orphan of speech recognition. And it seems we're the only ones who managed to handle the Russian–Serbian pair.
The challenge
If you know a model or service that can beat our numbers on aggressive word-level Russian–Serbian switching, write to us. Seriously: we will run it through the benchmark and publish the result, whatever it turns out to be. We are considering shaping the benchmark into a research note: for low-resource languages, reproducible benchmarks right now seem to be needed more than new models.
And if you teach Serbian (or any other language) and want to see what a summary of your own lesson looks like with the languages separated: try Jazion or just drop us a line. We'll show you on your own recording.
Как мы научили Gemini слышать русский внутри сербского
Пословный code-switching русский–сербский не умеет ни один сервис. Мы измерили 15 моделей и собрали своё решение на Gemini.
…и почему похожие языки — худший случай для ИИ
TL;DR: Учитель сербского переключается на русский посреди фразы — и это ломает почти все коммерческие транскрипторы на рынке. Мы проверили пятнадцать моделей, собрали своё решение на Gemini (полгода работает в Jazion) и упаковали выводы в PDF с выстраданными уроками промптинга.
Эту историю я давно собирался рассказать. Именно code-switching, переключение между языками прямо посреди фразы, кардинально отличает транскрипцию языкового урока от привычной одноязычной и ставит планку так высоко, что взять её сегодня могут единицы. Полгода я то и дело возвращался к этой задаче, а на днях, перепроверяя качество моделей на одной из самых интересных и трудных пар, русский–сербский, понял: пора рассказать, как мы её взяли и как помог в этом Gemini.
Ужас транскрибаторов: Агрессивный Code-Switching
Вот фрагмент обычного онлайн-урока сербского. Учительница — носитель языка, ученики — русскоязычные. Урок идёт на сербском, но посмотрите внимательно:
[12:04] Mila: Pogledaj, ovo je akuzativ. Смотри, здесь окончание меняется. Jasno?
[12:09] Luka: Da, понятно. Akuzativ — je kao винительный?
(Диалог синтетический, но точно воспроизводит структуру реальных уроков: настоящие реплики учеников мы не публикуем.)
Сразу договоримся о словах, дальше они всплывут не раз. На языковом уроке обычно есть два языка: изучаемый (мы будем звать его Target) — тот, ради которого пришли, здесь сербский, и родной язык ученика (Native) — здесь русский. Бывают исключения: урок-погружение может идти целиком на Target, а иногда в речь вплетаются и третьи языки как примеры. Но в целях обучения интересен прежде всего Target, и чаще всего именно пара Target–Native сталкивается в одной фразе.
В записи урока, на которой мы измеряем качество, примерно каждое четырнадцатое слово — из родного, русского. Это не случайность и не «загрязнение» речи: учительница сознательно дублирует трудное место по-русски, а ученик отвечает на смеси, потому что так быстрее думается. Лингвисты называют это code-switching: переключение языков внутри разговора, иногда внутри одного предложения. А когда оно идёт пословно, скачками посреди фразы, его называют агрессивным, тот самый случай из заголовка. Для билингвов это норма жизни, для преподавателя иностранного — рабочий инструмент.
А для систем распознавания речи — кошмар.
Мы дали пример такой записи пятнадцати моделям: специализированным сервисам транскрипции и универсальным мультимодальным нейросетям. Большинство не справилось. Дальше: что именно сломалось, у кого, и почему мы в итоге собрали своё решение.
Что обещают сервисы и что нужно уроку
Почти каждый сервис обещает «70+ языков». На деле механика простая: послушал первые секунды, решил, на каком языке весь файл, и других языков дальше просто не ждёт. В лучшем случае переживёт пару интернациональных слов вроде «ok» или «marketing».
Уроку этого мало. Уроку нужно, чтобы система переключалась на каждом слове: «Pogledaj» — это сербский, «смотри» — это русский, и они стоят рядом. Без этого не работает ничего из того, ради чего школа вообще записывает урок: нельзя посчитать, сколько ученик говорил на изучаемом языке, нельзя собрать словарь новых слов, нельзя увидеть прогресс от «отвечает по-русски» к «отвечает по-сербски». Процент русского в речи ученика — это, по сути, обратная шкала прогресса, и чтобы её построить, каждое слово должно быть правильно атрибутировано.
Забавно, что пара русский–сербский тяжелее для машин, чем, скажем, русский–английский, и ровно потому, что языки похожи. Общие корни, родственная лексика и, главная подлость, кириллица: сербский официально пишется двумя алфавитами, и кириллический сербский внешне почти неотличим от русского. Модель «слышит» в сербской речи знакомые русские слова, и наоборот. У билингвов похожее называют перекрёстной активацией языков (оба языка активны разом, и близкие слова конкурируют), а у моделей мы прозвали это лингвистическим дальтонизмом: система видит, что слова разные, но не различает их цвета.
Важная оговорка: всё это не только про русский–сербский. Наш пайплайн считает любую пару Target–Native: русский–английский, русский–испанский, английский–немецкий. Русский–сербский мы взяли как самый сложный экзамен: близкие языки, общий алфавит и почти полное отсутствие готовых решений.
Сербский — сирота мира ASR
С сербским есть отдельная беда, и она не про code-switching. Его просто мало кто поддерживает.
Зимой мы прошерстили рынок систем распознавания речи (по-английски ASR, automatic speech recognition) и обнаружили закономерность, которая сначала показалась шуткой: хорватский в списках поддерживаемых языков встречается примерно вдвое чаще сербского. У NVIDIA в свежих открытых моделях Parakeet и Canary 25 европейских языков: хорватский есть, сербского нет. Speechmatics: хорватский есть, сербского нет. Voxtral от Mistral, Qwen3-ASR от Alibaba, Yandex SpeechKit: сербского нет вообще. AssemblyAI в начале 2026-го выпустил новое поколение моделей и сократил список языков до шести; сербский не выжил. Малоресурсные языки не приобретают поддержку со временем, как можно было бы надеяться. Они её теряют.
[!spotlight] О разнице сербского и хорватского (ChatGPT, декабрь 2025): При транскрибировании аудио разница между сербским и хорватским становится не академической, а очень практичной. Вот наглядные примеры, где одно неверное решение сразу «палит» язык.
1) Экавский и иекавский рефлекс. Самый частый маркер на слух. Сербский: mleko, vreme, dete. Хорватский: mlijeko, vrijeme, dijete. Если в расшифровке написать mleko вместо mlijeko, хорватский текст мгновенно превращается в сербский.
2) Лексика: одинаково звучит, по-разному называется. Сербский: voz, hiljada. Хорватский: vlak, tisuća. В аудио человек скажет именно одно из них, и «универсального» варианта тут нет.
3) Буква H, которую сербы любят «терять». В сербской речи h часто редуцируется или исчезает: на слух леб, ладно там, где хорватский пишет hljeb, hladno. При транскрипции важно не «восстанавливать» букву автоматически, а писать то, что реально произнесено.
4) Будущее время: слитно или раздельно. В аудио звучит почти одинаково, но в тексте различие принципиальное. Сербский: uradiću. Хорватский: uradit ću.
5) Đ против DŽ. Хорватский различает их строго, сербский — мягче. Đevojka звучит мягко, почти как один звук, и в хорватской транскрипции это обязательно đ, а не dž.
Итог простой. При транскрибировании аудио важно не только «что сказали», но и в рамках какой языковой нормы это сказали. Сербский и хорватский звучат как близнецы, но в тексте они сразу начинают спорить за паспорт.
Соблазн велик: раз языки так близки, почему не взять для сербского хорватскую модель? Мы попробовали. Работает. До первого молока и любого слова, где иекавица выдаёт хорватский. Сербские преподаватели замечают это мгновенно: наш ИИ-ассистент однажды сгенерировал задание с иекавицей, и нам сообщили в первые же сутки. С тех пор языковая норма прибита гвоздями в каждом промпте. А сами носители шутят об этом лучше нас: сорок лет назад «Top Lista Nadrealista» довела «четыре языка одного языка» до абсурда в легендарном скетче.
Как вообще измерить «хорошую транскрипцию»
Прежде чем показывать таблицу, два слова о том, что в ней за числа. Обещаем: одна формула на всю статью, и та школьная.
Представьте, что эталонная фраза — «mama je kupila mleko». Модель услышала «mama kupila mlijeko sutra». Она потеряла одно слово (je), исказила одно (mleko → mlijeko) и добавила лишнее (sutra). Три ошибки на четыре эталонных слова. Доля ошибок — три четверти, или 75%. Это и есть WER (word error rate, пословная ошибка распознавания): сумма замен, потерь и вставок, делённая на длину эталона. Чем меньше, тем лучше; ноль — идеал.
У WER есть забавное свойство: он бывает больше 100%. Если модель нагенерировала больше мусора, чем было слов в эталоне, счётчик уходит за сотню; в наших тестах такие персонажи были.
Вторая метрика — DER (diarization error rate): как часто реплика приписана не тому человеку. Диаризация — это ответ на вопрос «кто говорил», и на групповом уроке с шестью участниками она важна не меньше точности слов: статистика ученика, собранная из чужих реплик, хуже, чем никакой.
Под капотом у этих метрик свои тонкости: сербский в двух алфавитах сравниваем через транслитерацию, «угу» и «ммм» отсекаем как шум. Но главная боль — эталон, вручную выверенная транскрипция, без которой сравнивать не с чем. Наш занял четыре часа кропотливой разметки на двадцать пять минут урока. Если вам скажут, что разметка данных — это просто, покажите им урок сербского с шестью говорящими.
Полгода от боли до прорыва
Мы бьёмся над этой задачей с ноября 2025-го. Сначала научились её измерять: собрали ручной эталон и прогнали через него всё, что было на рынке. Специализированные сервисы сыпались один за другим: кто-то не знал сербского, кто-то знал, но терял русские вкрапления. Потом два дня почти безостановочного промптинга, и 23 декабря случился прорыв: Gemini научилась держать оба языка одновременно, меньше 17% ошибок в словах и около 10% в определении говорящих. Это лучший результат для пословного переключения на малоресурсном языке, который мы видели где-либо. С тех пор решение полгода тихо работает в Jazion: учителя получают конспекты, словари и тот самый «процент русского», который показывает прогресс лучше любых тестов. Главный вывод этих шести месяцев простой: пословный code-switching — задача решаемая, но решение пришлось собирать самим. Как именно, мы ни разу не рассказывали. Исправляемся, а заодно перепроверим: вдруг рынок нас догнал?
Июнь 2026: перепроверка рынка
Мы прогнали тот же фрагмент аудио через актуальные версии всех основных сервисов, включая новые поколения Gemini. Вот выжимка из таблицы:
| Сервис | Ошибка в словах (WER) | Кто говорил (DER) | Что с русскими вкраплениями |
|---|---|---|---|
| Gemini (наша конфигурация) | 24% | 18% | ловит и пишет по-русски |
| ElevenLabs Scribe v2 | 29% | 20% | транслитерирует в латиницу |
| OpenAI gpt-4o-transcribe | 36% | нет диаризации | не слышит вовсе |
| AssemblyAI Universal-2 | 42% | 42% | теряет половину |
| Deepgram Nova-3 | 51% | 29% | топит сербский в русском |
| Gladia | 75% | 49% | пишет всё по-русски |
| Whisper large-v3 | 77% | 63% | мечется между алфавитами |
Пословная ошибка (WER) по проверенным сервисам: Gemini в нашей конфигурации держит оба языка, остальные уходят в стену ошибок
Самое важное в таблице — последняя колонка. Каждый сервис проваливается одним из двух способов, и оба делают данные урока бесполезными. Одни глухи к русскому: gpt-4o-transcribe не записал ни одного русского слова, Scribe аккуратно переписывает русский латиницей. В статистике ученика это просто потерянные реплики. Другие тонут в русском: Gladia, единственный сервис с официальным обещанием пословного переключения, услышал русские вставки и перевёл почти весь сербский урок в русский: на 67 русских слов эталона выдал 440. Сбалансировать оба языка не смог ни один специализированный сервис. А значит, по таким транскриптам школа не сможет понять, сколько ученик реально говорил по-сербски. Вот та стена, ради которой мы и собрали своё решение.
Справедливости ради: у Scribe оказалась отличная диаризация, лучшая среди протестированных «чистых» ASR. Если бы наш урок был одноязычным, это был бы сильный выбор. Его погубил именно язык.
Насколько нам известно (и июньский бенчмарк это подтверждает), ни один публичный сервис распознавания речи сегодня не справляется с пословным переключением русский–сербский на пригодном для работы уровне. Мы не нашли решения. Поэтому собрали своё.
[!mascot] мурлычет на двух языках «Mačke razumeju sve jezike. Мы просто отвечаем на своём.» (серб. «Кошки понимают все языки») 🐾
Почему универсальная модель победила специалистов
Наше решение построено не на ASR-сервисе, а на мультимодальной модели Google Gemini. Разница принципиальная. Специализированная модель распознавания учится сопоставлять звук и буквы; список языков для неё — буквально список, и сербский в него чаще всего не попадает. Большая мультимодальная модель обучалась на огромных объёмах текста и речи, включая сербские форумы, учебники, субтитры и аудио. Поэтому она знает не только как звучит сербский, но и как ведёт себя смешанная речь, и понимает инструкцию «русские слова пиши кириллицей, сербские — латиницей» как осмысленное правило, а не как настройку.
На практике это выглядит так: тринадцать минут шестиголосого урока Gemini транскрибирует за полминуты, с диаризацией, обоими языками и правильной экавицей. Стоимость — приятная мелочь: транскрипция целого часа урока обходится дешевле чашки кофе, и рынок в целом продолжает дешеветь (редкое исключение: AssemblyAI с июля поднимает цену региональной обработки на 10%). Мы пробовали и специализированный Google Speech v3: на наших данных он уступает даже младшим моделям Gemini, что само по себе знак времени. Универсальные модели начали обгонять узких специалистов на их собственном поле.
С Gemini мы работаем давно: ещё в прошлом проекте Emotions Shazam она отлично показала себя на анализе просодики, то есть интонаций и эмоций в речи. Но хвалить честно — значит называть и границы: пословные таймкоды на длинных записях (час и больше) модель пока держит нестабильно, а чтобы она надёжно различала сербский и русский в пословном переключении, ушло немало итераций до и после; решающий прорыв сложился за пару суток почти безостановочного промптинга. Подробности мы упаковали в отдельную шпаргалку в конце статьи.
💡 Как это работает в Jazion: транскрипция с разделением языков — не отдельная функция, а фундамент. Поверх неё платформа автоматически строит конспект урока, персональный словарь каждого ученика (как он устроен, рассказываем в посте про DDL), статистику речи и динамику «процента родного языка» от урока к уроку. Для учителя всё это — одна кнопка после урока.
Качество под присмотром
Модели не стоят на месте: они обновляются, и со временем их поведение меняется. Это известное в индустрии явление, дрейф моделей, и мы с ним уже сталкивались на собственных данных. Поэтому у нас есть воспроизводимый бенчмарк, которым мы регулярно перепроверяем и рынок, и собственное качество. Если где-то что-то проседает, мы замечаем это первыми и заново подбираем конфигурацию. Для школы это значит простое: качество транскрипции у вас под присмотром, а не на авось.
🔧 Забирайте: уроки промптинга, оплаченные часами
Мы не публикуем боевой промпт: он наше Know How. Но уроки, выученные в многодневной борьбе с code-switching, переносимы на любые задачи: от транскрипции до генерации заданий. Мы собрали их в двухстраничный PDF: десять правил, иерархию слов-мандатов CRITICAL/MUST/NEVER и протестированный демо-промпт, который можно прямо сейчас попробовать на своей записи в Google AI Studio.
Скачать PDF RU (требуется login)
Главный вывод
Сербский — сирота распознавания речи. И кажется, мы единственные, кто смог обработать пару RU+SR.
Вызов
Если вы знаете модель или сервис, который побьёт наши цифры на агрессивном пословном переключении русский–сербский, напишите нам. Серьёзно: мы прогоним его через бенчмарк и опубликуем результат, каким бы он ни был. Бенчмарк мы подумываем оформить как небольшую научную публикацию (research note): для малоресурсных языков воспроизводимые бенчмарки сейчас, кажется, нужнее новых моделей.
А если вы преподаёте сербский (или любой другой язык) и хотите увидеть, как выглядит конспект вашего собственного урока с разделением языков: попробуйте Jazion или просто напишите нам. Покажем на вашей записи.